¿Sabes lo que pasa? Que una inteligencia artificial no siempre aprende mirando respuestas correctas. A veces aprende probando, equivocándose y descubriendo qué decisiones la acercan a su objetivo.
Última revisión: 12 de agosto de 2026.
Aprender a base de prueba, error y recompensa
En el aprendizaje por refuerzo, un sistema —al que llamamos agente— interactúa con un entorno. El agente observa la situación, elige una acción y recibe una señal: una recompensa si esa acción ayuda o una penalización si lo aleja del objetivo.
Con muchas experiencias, intenta aprender una estrategia que consiga la mayor recompensa acumulada posible. No se limita a buscar un premio inmediato: a veces tiene que aceptar un resultado pequeño ahora para obtener uno mejor más adelante.
Las cuatro piezas que debes reconocer
1. El agente
Es quien toma las decisiones. Puede ser un personaje de videojuego, un brazo robótico o un programa que gestiona recursos.
2. El entorno
Es el mundo en el que actúa: la pantalla del juego, una simulación o un espacio físico.
3. Las acciones
Son las opciones disponibles: avanzar, girar, mover una pieza, acelerar o esperar.
4. La recompensa
Es la señal que indica qué resultados interesan. Puede sumar puntos por alcanzar una meta y restarlos por chocar, perder tiempo o incumplir una regla.
El ejemplo del perro ayuda… con cuidado
En la publicación original lo comparábamos con enseñar a un perro a sentarse: si lo hace bien, premio; si no, se prueba otra vez. La metáfora sirve para entender la idea de refuerzo, pero una IA no siente satisfacción ni frustración. La “recompensa” es simplemente un número que guía el aprendizaje.
Explorar o repetir lo que ya funciona
Imagina que el agente llega a un cruce. Puede repetir el camino que ya le dio puntos o probar otro que quizá esconda una recompensa mayor. Ese equilibrio entre explotar lo aprendido y explorar alternativas es uno de los problemas centrales del aprendizaje por refuerzo.
Si solo repite, puede quedarse con una solución mediocre. Si solo explora, nunca aprovecha lo que ya sabe.
De Atari a AlphaGo
En 2013, un equipo de DeepMind presentó un sistema que combinaba aprendizaje por refuerzo y redes neuronales para aprender a jugar a varios juegos de Atari a partir de los píxeles de la pantalla. El trabajo fue ampliado y publicado en Nature en 2015: el mismo agente alcanzó un nivel comparable al de un probador profesional humano en un conjunto de 49 juegos.
En 2016, AlphaGo venció por 4 partidas a 1 a Lee Sedol, uno de los grandes jugadores de Go de su época. Conviene contarlo bien: AlphaGo no utilizó una sola técnica. Combinó redes neuronales, búsqueda, aprendizaje a partir de partidas humanas y aprendizaje por refuerzo mediante partidas contra distintas versiones de sí mismo.
Ejemplo sencillo: salir de un laberinto
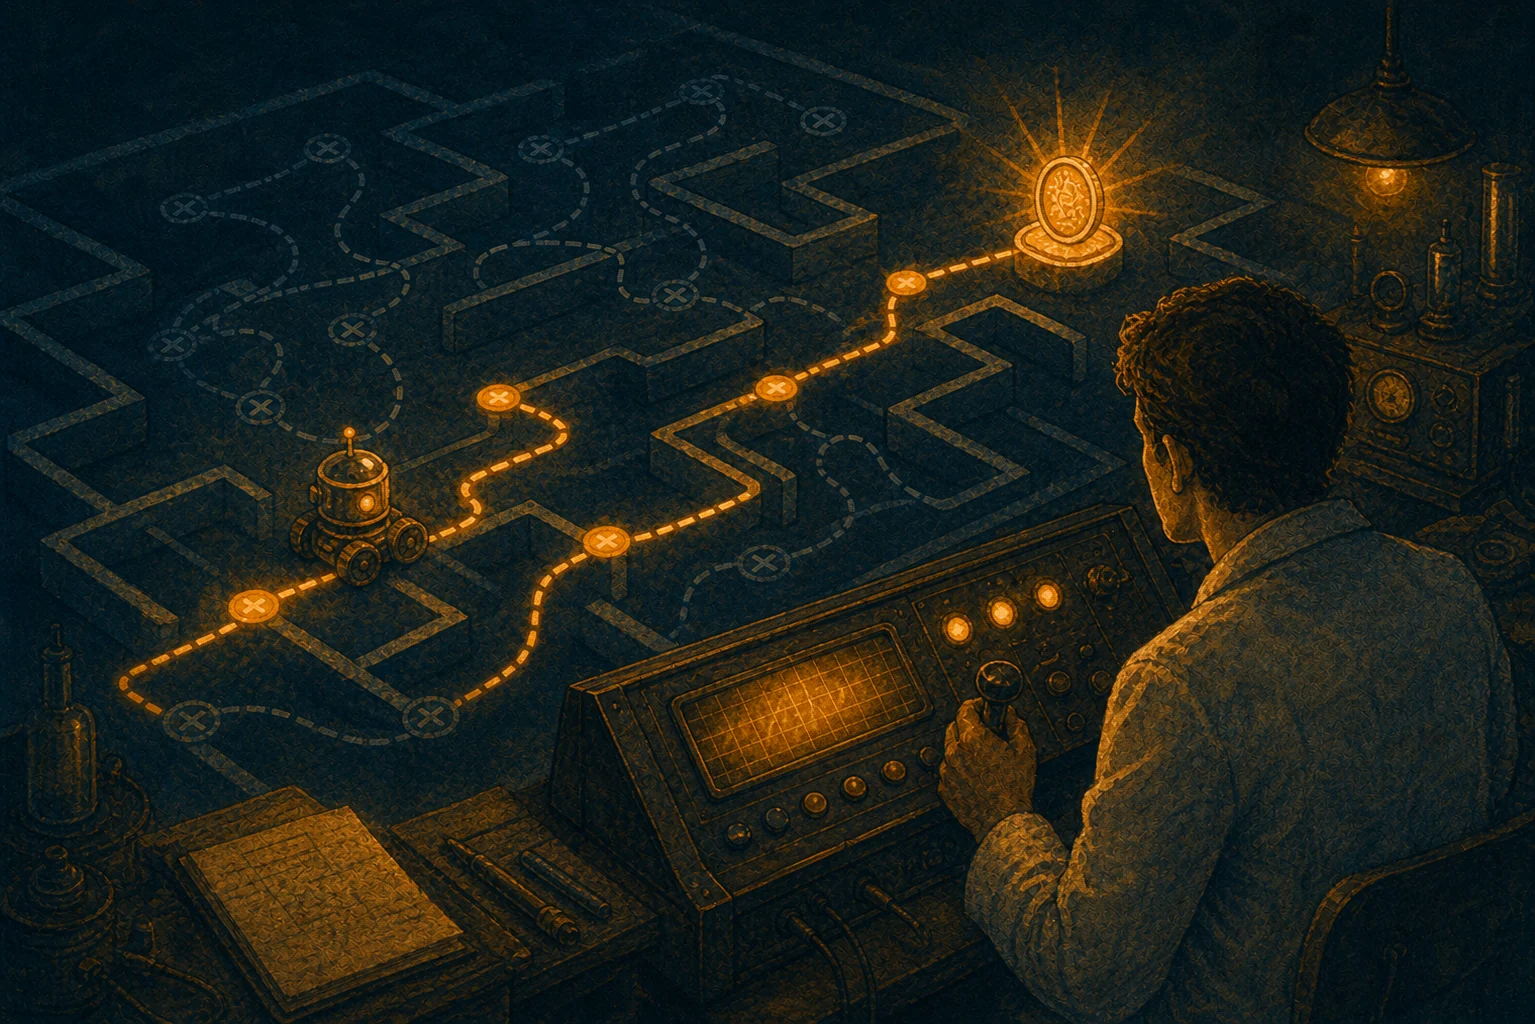
Imagina un agente dentro de un laberinto. Recibe un punto por avanzar hacia la salida, pierde puntos si choca y obtiene una recompensa grande cuando llega a la meta. Al principio se mueve casi al azar. Tras muchos intentos, ciertas rutas empiezan a aparecer como mejores que otras.
Pero aquí está la trampa: si premiamos únicamente que llegue rápido, quizá aprenda un atajo que nosotros no esperábamos. El agente persigue la señal que hemos definido, no nuestras intenciones ocultas.
No significa “dejar que aprenda completamente solo”
Alguien sigue decidiendo qué acciones puede realizar, qué información observa, qué significa ganar y cómo se calcula la recompensa. Diseñar bien esas reglas es tan importante como el algoritmo. Una recompensa mal planteada puede producir un comportamiento eficaz según los puntos… y desastroso según el objetivo real.
Prueba mental de 30 segundos
Quieres enseñar a una IA a ahorrar energía en una casa. ¿Qué premiarías: consumir lo mínimo, mantener una temperatura cómoda o ambas cosas? Si solo premias reducir el consumo, la solución perfecta podría ser apagarlo todo. Acabas de descubrir por qué definir bien el objetivo importa tanto.
Qué debes recordar
- El agente aprende al actuar dentro de un entorno y recibir señales de recompensa.
- Busca una estrategia que funcione a largo plazo, no únicamente el premio inmediato.
- Debe equilibrar explorar alternativas y aprovechar lo que ya ha aprendido.
- AlphaGo combinó aprendizaje por refuerzo con otras técnicas; no fue una única fórmula mágica.
- Una recompensa mal diseñada puede enseñar el comportamiento equivocado.
Próximo capítulo: Big Data
Para aprender patrones complejos no basta con probar muchas veces. También hacen falta datos, y no todos los datos sirven igual. En el capítulo 8 veremos por qué el Big Data impulsó la IA y qué problemas aparecen cuando confundimos cantidad con calidad.
Fuentes para seguir tirando del hilo
- Sutton y Barto: Reinforcement Learning: An Introduction (2.ª edición).
- Mnih y otros: Playing Atari with Deep Reinforcement Learning (2013).
- Mnih y otros: Human-level control through deep reinforcement learning, Nature (2015).
- Silver y otros: Mastering the game of Go with deep neural networks and tree search, Nature (2016).
- Google DeepMind: cómo aprendía AlphaGo y el desafío contra Lee Sedol.
- Capítulo 7 original de @palmercanarias.ia, publicado el 9 de abril de 2025.
Cuéntanos tu experiencia