¿Sabes lo que pasa? Que las redes neuronales no nacieron en 2012. Llevaban décadas rondando los laboratorios. Lo que cambió fue que, por fin, coincidieron tres ingredientes: muchos datos, máquinas capaces de hacer una barbaridad de cálculos y mejores formas de entrenar redes con numerosas capas.
Última revisión: 12 de agosto de 2026.
Primero: ¿qué significa “profundo”?
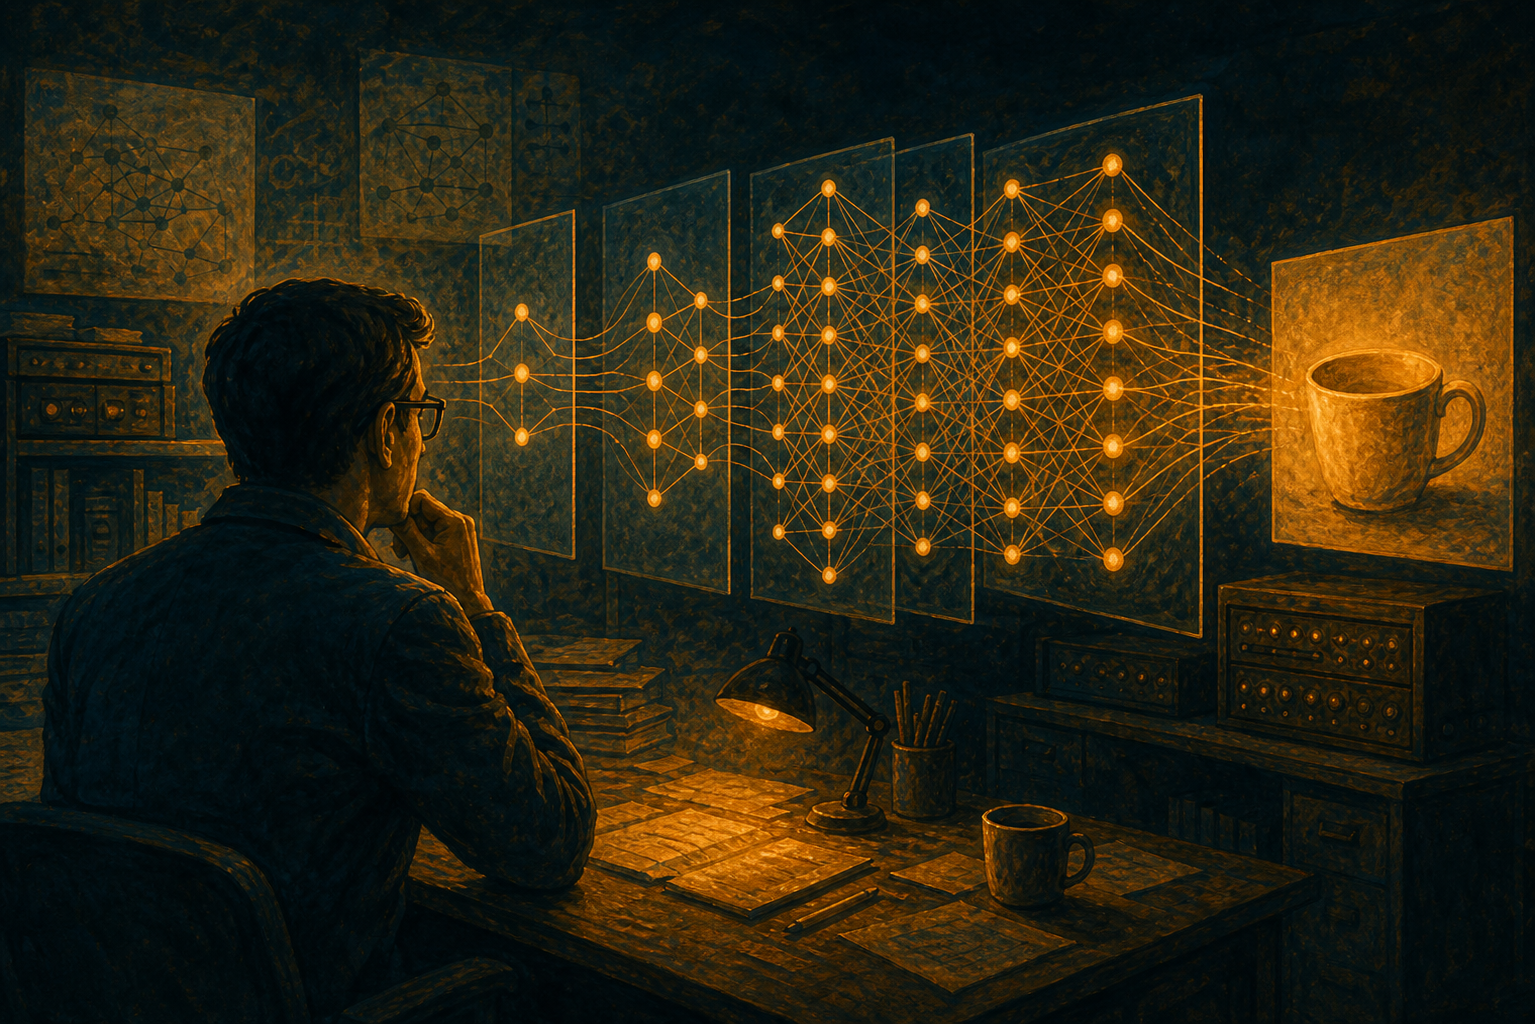
El aprendizaje profundo, o deep learning, es una forma de aprendizaje automático que utiliza redes neuronales con varias capas de procesamiento. Cada capa transforma la información y entrega el resultado a la siguiente.
Imagina una cadena de detectives: el primero encuentra bordes, el segundo combina esos bordes en formas y los siguientes reconocen partes cada vez más complejas hasta decir “esto parece una taza”.
La profundidad no significa que la máquina piense con más profundidad que una persona. Significa, sencillamente, que los datos atraviesan más capas de operaciones.
El momento que hizo girar muchas cabezas
En 2012, Alex Krizhevsky, Ilya Sutskever y Geoffrey Hinton presentaron una red neuronal conocida como AlexNet. La entrenaron para clasificar imágenes del conjunto ImageNet y obtuvo un resultado mucho mejor que el de los sistemas que competían con ella.
No inventaron de repente todas las ideas del aprendizaje profundo. Su trabajo demostró de una manera difícil de ignorar que combinar redes profundas, grandes cantidades de ejemplos y unidades de procesamiento gráfico —las famosas GPU— podía producir un salto enorme en reconocimiento de imágenes.
¿Por qué no ocurrió veinte años antes?
1. Faltaban datos
Una red grande necesita muchísimos ejemplos. La expansión de internet y proyectos como ImageNet permitieron trabajar con colecciones de imágenes a una escala que antes era impensable.
2. Faltaba potencia de cálculo
Entrenar una red implica repetir millones de operaciones. Las GPU, creadas originalmente para procesar gráficos, resultaron especialmente útiles para hacer muchos cálculos en paralelo.
3. Faltaban piezas del método
Las ideas anteriores seguían ahí, pero nuevas técnicas y mejoras prácticas hicieron posible entrenar redes más grandes sin que el proceso se volviera inútil o imposible de manejar.
Lo que empezó a cambiar
Después de aquel salto, las redes profundas comenzaron a mejorar el reconocimiento de voz, la traducción automática, la visión artificial y muchas otras tareas. No era magia: eran sistemas especializados aprendiendo patrones a partir de cantidades enormes de datos.
El mismo principio de construir representaciones por capas ayuda a explicar buena parte de la IA actual, aunque los modelos modernos sean mucho mayores y utilicen arquitecturas diferentes.
Prueba mental de 30 segundos
Piensa en cómo reconocerías una bicicleta en una fotografía. Quizá no buscarías “una bicicleta” de una sola vez. Detectarías círculos, líneas, un cuadro, un manillar y una relación concreta entre esas piezas. Una red profunda también puede ir formando representaciones progresivas, aunque sus cálculos no sean una copia del cerebro humano.
Qué debes recordar
- El deep learning pertenece al aprendizaje automático.
- “Profundo” se refiere a las múltiples capas de procesamiento.
- Su auge no tuvo una sola causa: coincidieron datos, potencia y mejoras técnicas.
- AlexNet convirtió 2012 en un momento decisivo para la visión artificial moderna.
- Reconocer patrones muy bien no equivale a comprender el mundo como una persona.
Cuéntanos tu experiencia