¿Sabes lo que pasa? Una sola base puede acabar sosteniendo cosas muy diferentes. Piensa en una buena educación general: no te convierte automáticamente en médico, traductor o diseñador, pero te da conocimientos que después puedes orientar hacia cualquiera de esos caminos.
Con la inteligencia artificial ocurrió algo parecido. Tras aprender a reutilizar modelos preentrenados, investigadores y empresas empezaron a construir sistemas entrenados con datos muy amplios y pensados para servir como punto de partida de muchas aplicaciones. En 2021, un grupo de Stanford popularizó para ellos el nombre modelos fundacionales.
Una base amplia, no una aplicación terminada
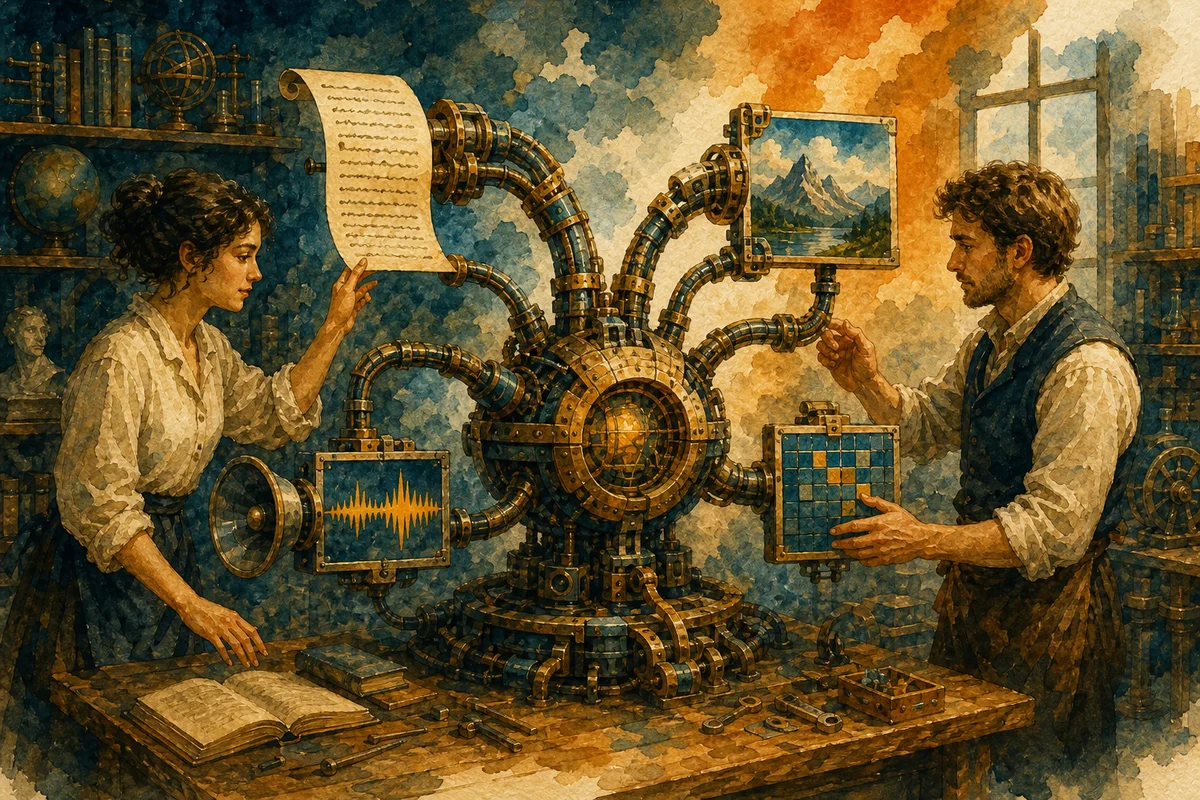
Un modelo fundacional se entrena a gran escala con datos diversos. Después puede adaptarse o guiarse para realizar tareas distintas: resumir, clasificar, conversar, buscar patrones, crear contenido o servir como parte de una herramienta más especializada.
El modelo es la base. El chatbot, el buscador o la aplicación que utilizas es el edificio construido sobre ella.
Esta diferencia evita una confusión habitual. ChatGPT, por ejemplo, es un producto con una interfaz, instrucciones, herramientas y medidas de seguridad. Debajo utiliza uno o varios modelos. No son exactamente la misma cosa.
¿En qué se diferencia de un modelo preentrenado?
Los dos conceptos están relacionados, pero cuentan historias distintas:
- Preentrenado describe el proceso: el modelo aprendió una base antes de llegar a nuestra tarea concreta.
- Fundacional describe el papel que puede desempeñar: esa base amplia sirve para construir muchas aplicaciones posteriores.
Por eso un modelo fundacional suele estar preentrenado, pero no todo modelo preentrenado tiene por qué convertirse en la base de un ecosistema de usos.
Del lenguaje a varias formas de información
Algunos modelos trabajan principalmente con texto. Otros se entrenan con imágenes, audio, vídeo o combinaciones de varios tipos de datos. Cuando un sistema puede relacionar más de una de esas formas —por ejemplo, entender una fotografía y conversar sobre ella— hablamos de un modelo multimodal.
Esto no significa que «vea» o «comprenda» como una persona. Aprende relaciones estadísticas entre los datos y genera una respuesta a partir de ellas. Puede resultar muy útil y, al mismo tiempo, equivocarse con una seguridad sorprendente.
Un ejemplo cotidiano: la misma base, cuatro ayudantes
Imagina que una organización parte de un mismo modelo fundacional y crea cuatro herramientas:
- Un asistente que resume documentos internos.
- Un sistema que clasifica mensajes de atención al cliente.
- Una ayuda para redactar respuestas siguiendo un tono concreto.
- Un buscador que localiza información dentro de manuales autorizados.
Las aplicaciones no tienen por qué comportarse igual. Cada una puede añadir instrucciones, datos, permisos, filtros y comprobaciones diferentes. Compartir una base no elimina la necesidad de diseñar y evaluar bien cada uso.
La gran ventaja también es el gran riesgo
Crear muchas herramientas sobre una base común ahorra trabajo y permite que más personas aprovechen capacidades avanzadas. Pero los fallos de esa base también pueden viajar hacia todas las aplicaciones que dependen de ella.
Si el modelo representa peor un idioma, arrastra sesgos, desconoce información reciente o genera datos falsos, el problema puede reaparecer en muchos lugares. Stanford llamó la atención precisamente sobre esa doble cara: un enorme potencial y riesgos que se multiplican al reutilizar la misma base.
Haz una prueba: localiza el modelo y la aplicación
Abre una herramienta de IA que utilices y busca su información oficial. Intenta responder:
- ¿Cómo se llama el producto o la aplicación?
- ¿Indica qué modelo o familia de modelos utiliza?
- ¿Puede trabajar con texto, imágenes, audio o archivos?
- ¿Qué datos le estás permitiendo recibir?
Si no encuentras alguna respuesta, no la inventes. Apunta «no lo sé todavía». Aprender IA también consiste en distinguir lo que sabemos de lo que simplemente suponemos.
Qué debes recordar
- Un modelo fundacional se entrena con datos amplios y puede adaptarse a muchas tareas.
- El término se popularizó en 2021 con el trabajo del Stanford CRFM.
- Modelo y aplicación no son sinónimos: la aplicación añade contexto, herramientas y reglas.
- Puede trabajar con una modalidad o combinar texto, imagen, audio y otros datos.
- Reutilizar una base multiplica sus posibilidades, pero también puede extender sus errores y sesgos.
Palabrejas de este capítulo
Modelo fundacional, multimodal, aplicación, adaptación, tarea posterior y modelo de lenguaje. El Diccionario sin humo está para consultarlas cuando las necesites.
Fuentes y revisión
Entrada reconstruida a partir del capítulo 11 original de @palmercanarias.ia, publicado el 23 de abril de 2025, y ampliada, corregida y revisada el 30 de agosto de 2026.
- Stanford CRFM: informe original sobre las oportunidades y riesgos de los modelos fundacionales.
- Stanford HAI: presentación del Center for Research on Foundation Models.
- NIST: definición actual de modelo fundacional.
En el capítulo 12 veremos qué ocurre cuando estos sistemas no solo analizan información, sino que generan texto, imágenes, audio y otros contenidos.
Cuéntanos tu experiencia